Text-to-VideoとImage-to-Videoの違い|最初に固定できる情報を比べる
動画AIの入力方法を選ぶときは、まず「すでに決まっている見た目があるか」を考えます。文章から場面を作りたいならText-to-Video、使いたい写真や開始画があるならImage-to-Videoが候補です。この記事では画質の順位ではなく、制作を始める位置の違いを整理します。
動画AIの入力方法を選ぶときは、まず「すでに決まっている見た目があるか」を考えます。文章から場面を作りたいならText-to-Video、使いたい写真や開始画があるならImage-to-Videoが候補です。この記事では画質の順位ではなく、制作を始める位置の違いを整理します。
文章から始めるときに決めること
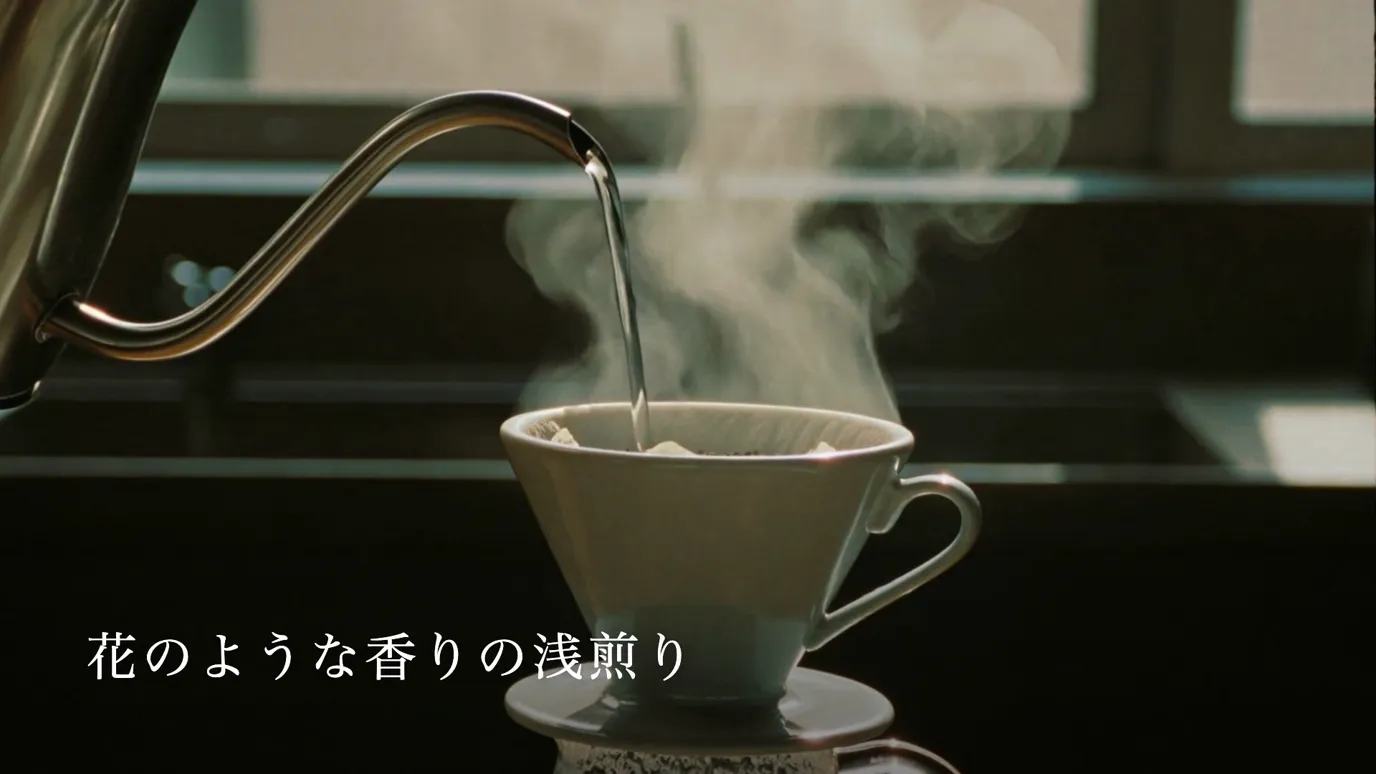
Text-to-Videoでは、誰が、どこで、何をする映像なのかを文章で伝えます。「静かな朝」のような雰囲気だけでは、主役や場所の解釈が広くなります。最初は「窓際の机に置かれた白いカップから湯気が上がる」のように、一つの場面を具体化してみます。これは説明用の例で、生成結果を検証した指示文ではありません。
商品や人物の外見が厳密に決まっている場合は、その条件を文章だけで伝えられるかを検討します。形の正確さが必要なら、参照画像を使える別の入力方法も含めて選びます。
画像から始めるときに決めること
Image-to-Videoでは、入力画像で構図や被写体を伝え、文章で動きを補う使い方ができます。Runwayの案内も、入力画像が構図・被写体・照明・画風を示し、文章で動きや時間の進行を指定する考え方です。ただし、これは動き始めた後の形や顔を完全に固定する保証ではありません。Runway公式ガイド
最初の画像は、動画の出発点として確認します。手が器具を持っていないのに注ぐ動作を頼んだり、商品が端で切れた画像から全体を見せようとしたりすると、画面外の情報を補う必要があります。必要な形と開始姿勢が写っているかを先に見ます。
同じコーヒーでも準備が変わる
文章から作るなら、カップ、器具、背景、撮影位置を決めます。写真から作るなら、まず写真が使いたい商品の形と配置になっているかを確認し、その後に「湯が注がれる」「カメラが近づく」などの変化を指定します。
FablessBridgeには、同じドリップ画像をSeedance 2.5とKling 4.0へ渡した制作記録があります。入力画像を揃えた事例ですが、各1本で生成日や音声条件も異なるため、Image-to-Video全般の優劣を証明する比較にはしません。
入力方式を決める三つの質問
- 01最初の一枚として使いたい画像があるか。
- 02外見を守る対象と、動かす対象を言葉にできるか。
- 03今の画像から無理なく始められる動作か。
見た目から探索したい場面と、採用済みの見た目を動かしたい場面では、準備の順序が違います。方式を選んだら入力画像、指示文、モデル、利用サービスをセットで記録します。あとから結果を見返すとき、何を出発点にした映像なのかが分かる状態にしておきましょう。
制作のご相談
企画が固まっていない段階からご相談いただけます。
お問い合わせ料金と制作の流れを見る